AI信息片段随记(持续更新中...)
模型信息
- 国外主流通用模型:Gemini、Claude、ChatGPT、Grok
- 国内主流通用模型:DeepSeek、Qwen、GLM、Kimi、Hy4、MiniMax、Mimo、Seed
- 意图检测模型:Jev、Laya、Kev、SetFit
- 文字提取模型:Gliner、OpenLID(语言识别)
- 向量模型:bge-m3、 qwen3-embedding:0.6b、nomic-embed-text(非中文)、gte-large-zh、bge-large-zh-v1.5、m3e-base、tao8k
- Rag 重排小模型: 基于 Electra 架构的模型 、Bge Reranker、Voyage、Cohere、Jina Reranker、
- 文档解析模型:OXR
- 语音识别:Azure、SenseVoiceSmall
- 语音合成:F5-TTS、火山引擎
- 图像类:Real-ESRGAN、LaMa
- 时序类:Chronos-Bolt(销量流量预测)
- 视觉合成:Kimi 视觉模型、 字节即梦 AI
- 本地可以用 ollama,企业部署一般使用 vllm。
- 工作流: dify、coze、n8n 等智能体工作流平台
- AI 绘图领域:Stable Diffusion、 Black Forest Labs 团队的 FLUX 、智谱清言的 CogView 模型以及快手的可灵 AI
- 海外文件存储和 CDN:Bunny.net
- 模型社区:hugginFace、modelscope
- 个人本地部署模型:Bonsai
中文向量模型
TOP@n 表示前 n 个结果中相关检索的正确性: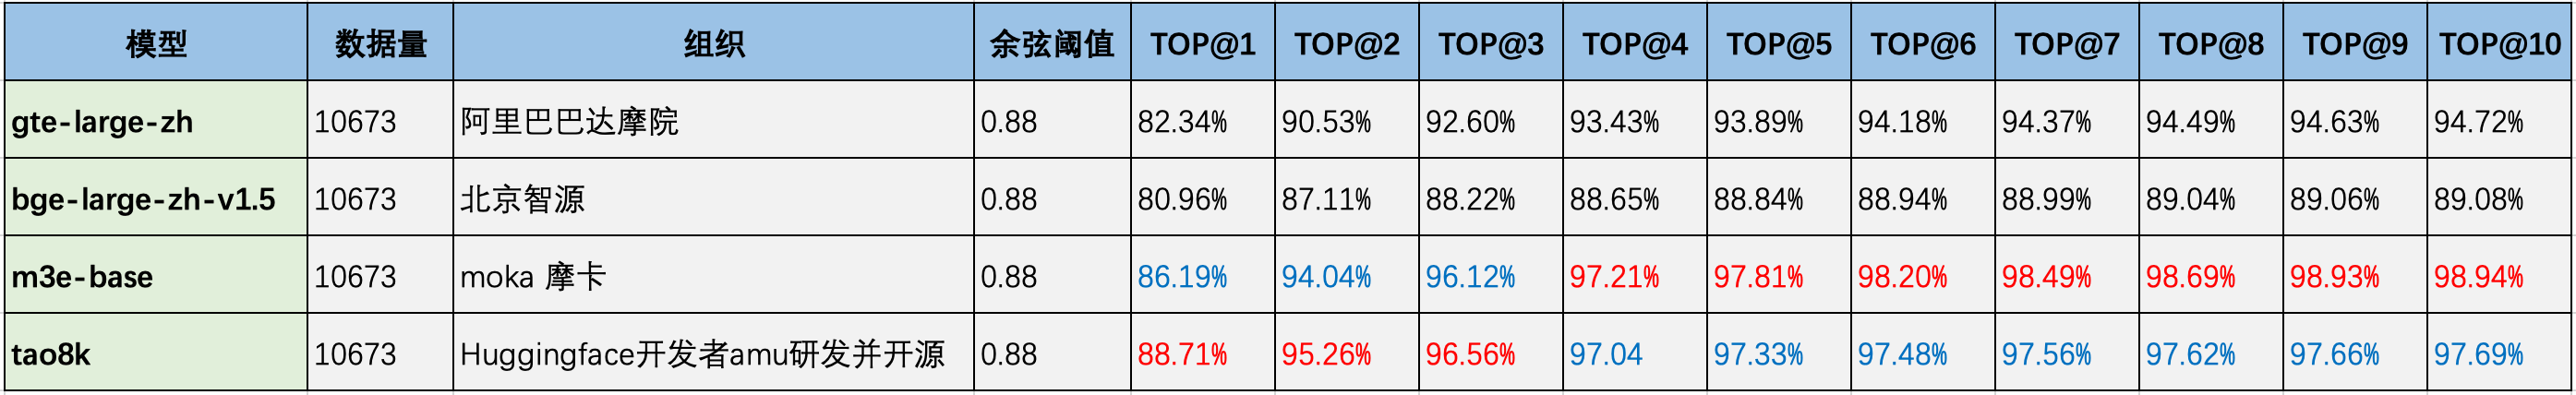
常用 API 服务
- Azure:https://portal.azure.com —— 微软云服务平台,常用来申请 Azure OpenAI 等模型 API 资源
- Bunny:https://bunny.net/ —— 海外文件存储与 CDN 服务,适合放图片、静态资源
- MinerU:https://mineru.net/ —— 文档解析服务,把 PDF 等文件转成可检索的 Markdown 文本
WebSeach API 服务
- Serper:serper.dev —— Google 搜索 API,把搜索结果以结构化数据返回给程序
- Tavily:tavily.com —— 面向 LLM / Agent 的搜索 API,返回适合喂给模型的网页摘要
- 博查:open.bochaai.com —— 国内搜索 API,为大模型和 RAG 应用提供中文网页检索结果
常用业务组件
- 图数据库:Neo4j
- 向量数据库:Milvus、PgVector、Sqllite(轻量)、Chroma(轻量)
- 关系型数据库:Mysql、PostgreSql(支持向量检索)
- 全文检索数据库:ElasticSearch
- 缓存中间件:Redis
- 对象存储: Minio、RustFS、云OSS服务
- 消息队列:RabbitMQ
相关框架
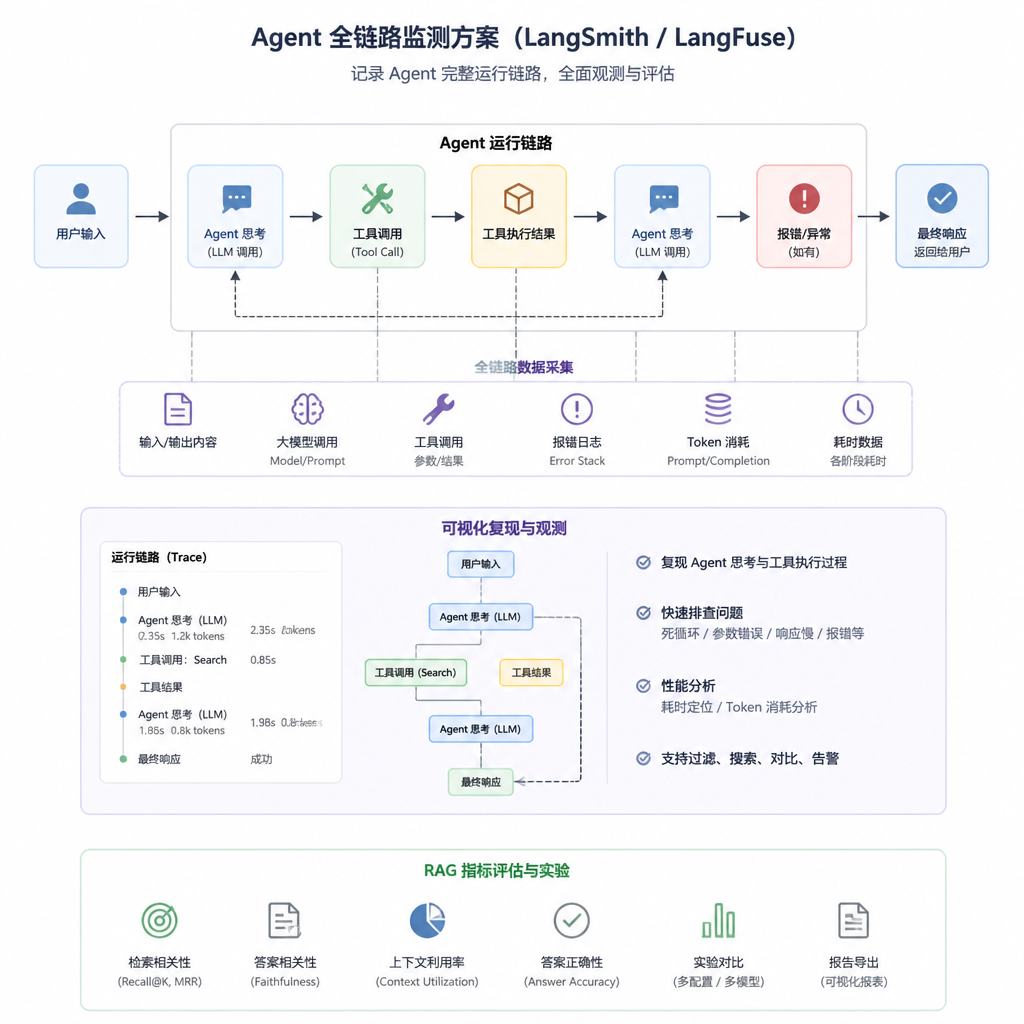
- Agent 全链路检测方案:LangSmith、LangFuse、OpenTelemetry.
- Agent长期记忆方案:Mem0、Claude-mem
知识库方案
AgentRAG(传统方式解决多跳) VS LLMWiKi(提前编译知识库解决多跳) VS GraphRAG(知识图谱) VS SAG2(关键词检索,多跳)
传统方式检索路径:
- 路径:问题重写 (可选)=> 关键词BM25 + 向量化检索 => RRF 加权融合 + Rerank 重排
- 强专业领域: 可加上HyDE假设文档检索
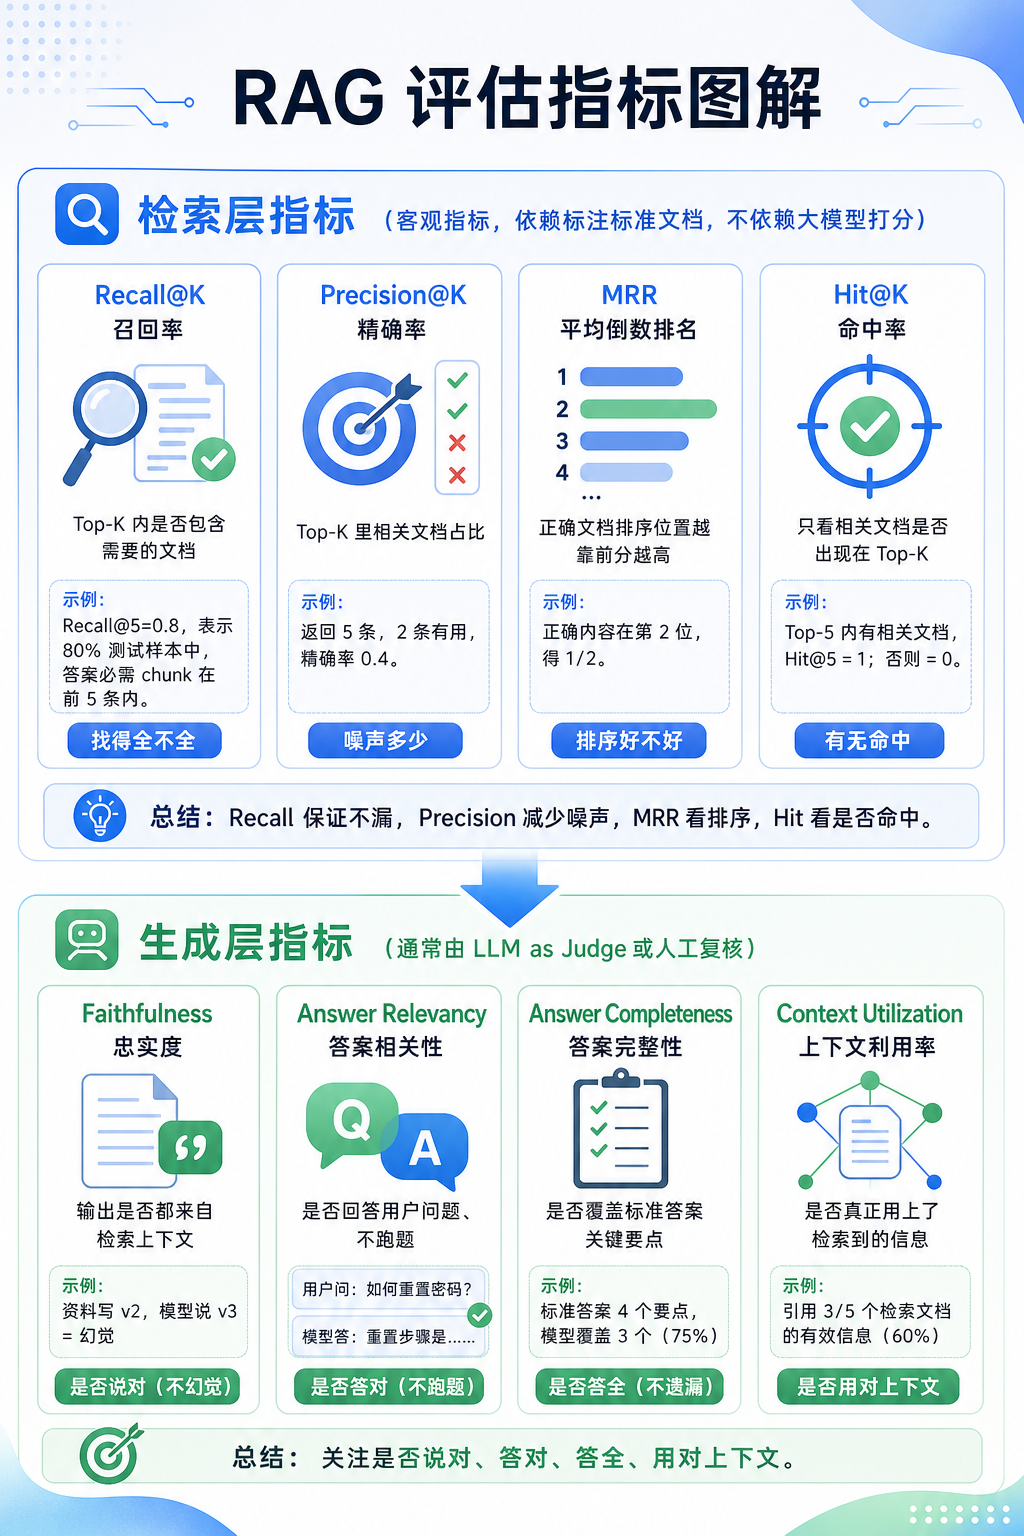
指标评估